ابزارهای تشخیص محتوای هوش مصنوعی همیشه پاسخ قطعی و قابل استنادی ارائه نمیکنند. نتیجه آزمایش عملی روی متنهای انسانی، بازنویسیشده و تولیدشده با مدلهای زبانی نشان میدهد که این ابزارها در بهترین حالت برای برآورد احتمال کاربرد هوش مصنوعی مناسباند، نه اثبات آن. بنابراین تشخیص محتوای هوش مصنوعی باید با بررسی سبک نگارش، سابقه تولید، منابع و ویرایش انسانی همراه شود.
ابزارهای تشخیص محتوای هوش مصنوعی چگونه کار میکنند؟
ابزارهای تشخیص محتوای هوش مصنوعی با تحلیل الگوهای آماری و زبانی، احتمال تولید متن توسط یک مدل زبانی را تخمین میزنند. این ابزارها معمولاً متن را به بخشهای کوچک تقسیم میکنند و ویژگیهایی مانند قابل پیشبینی بودن واژه بعدی، تنوع طول جمله، تکرار ساختارها، یکنواختی لحن و پیچیدگی نحوی را میسنجند.
یکی از مفاهیم مهم در این فرایند، پراکندگی یا تنوع متن است. نوشته انسانی معمولاً ترکیبی از جملههای کوتاه و بلند، انتخابهای واژگانی متفاوت، مکثهای طبیعی و گاهی ساختارهای نامنظم دارد. متن تولیدشده با هوش مصنوعی ممکن است بیش از حد منظم، متوازن و قابل پیشبینی باشد، هرچند مدلهای جدید این تفاوت را کمتر کردهاند.
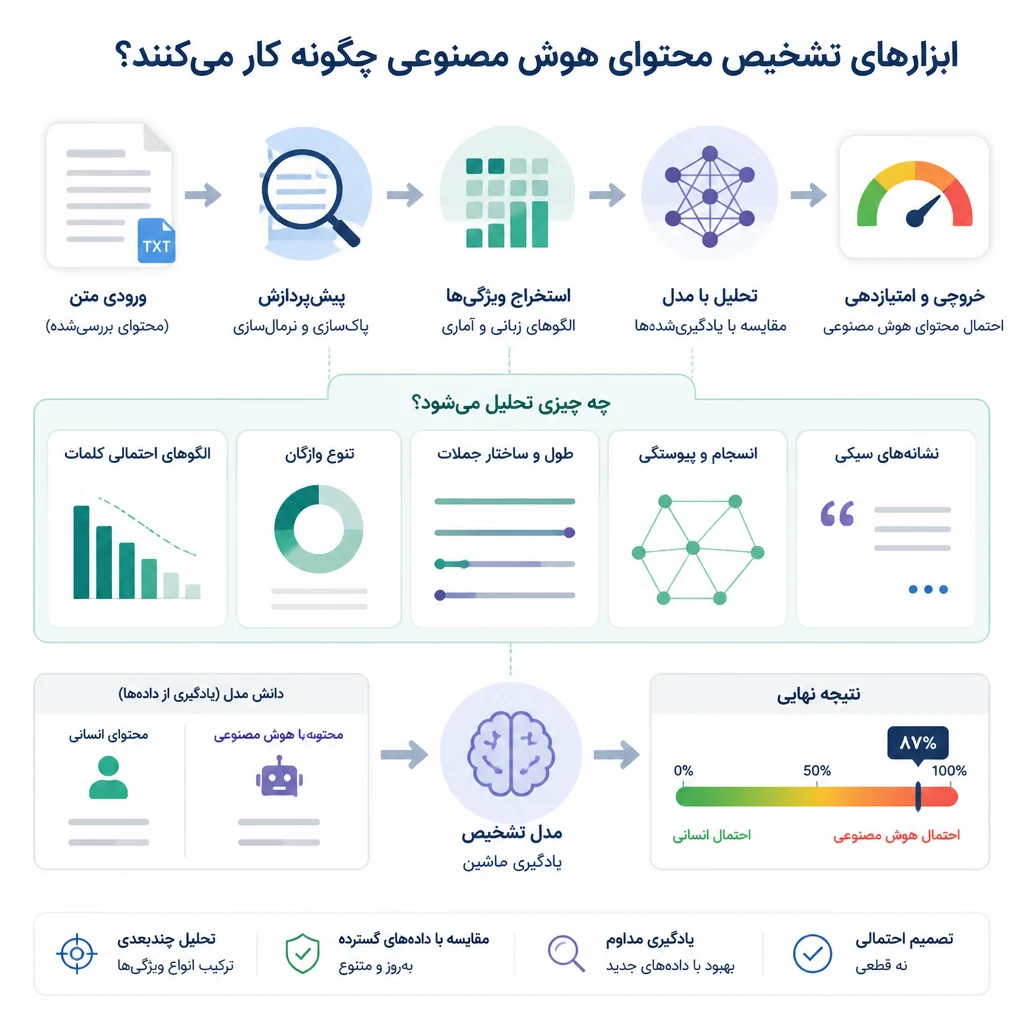
برخی سرویسها از مدلهای یادگیری ماشین اختصاصی استفاده میکنند و برخی دیگر متن را با الگوهای شناختهشده مدلهایی مانند GPT مقایسه میکنند. هیچکدام به محتوای ذهن نویسنده دسترسی ندارند و هیچ ابزار عمومی نمیتواند با اطمینان کامل بگوید چه کسی متن را نوشته است.
آزمایش عملی دقت ابزارهای تشخیص چه روشی داشت؟
در یک آزمایش عملی معتبر، باید چند نوع متن با موضوع، طول و سطح تخصص مشابه آماده و سپس در چند ابزار مستقل بررسی شود. مقایسه یک متن رسمی انسانی با یک متن کوتاه تولیدشده، نتیجهای سادهانگارانه ایجاد میکند و برای سنجش واقعی کافی نیست.
برای این بررسی، چهار گروه متن در نظر گرفته میشود: متن کاملاً انسانی، متن تولیدشده با یک مدل زبانی، متن تولیدشده و سپس ویرایششده توسط انسان، و متن انسانی که با ابزار بازنویسی یا ترجمه ماشینی تغییر کرده است. هر گروه بهتر است چند نمونه بین ۵۰۰ تا ۱۰۰۰ کلمه داشته باشد تا ابزار با کمبود داده مواجه نشود.
- ابتدا موضوع و دستور نگارش برای همه نمونهها یکسان انتخاب میشود.
- سپس متنهای انسانی از نویسندگان واقعی جمعآوری میشوند و نویسندگان از استفاده از ابزارهای مولد منع میشوند.
- متنهای هوش مصنوعی با یک دستور ثابت تولید میشوند تا تفاوت فقط به سبک خروجی مدل محدود بماند.
- بخشی از متنهای هوش مصنوعی با ویرایش سبک، اصلاح واقعیتها و تغییر ترتیب جملهها آماده میشوند.
- همه نمونهها بدون نام نویسنده، عنوان اضافی یا اطلاعات قابل شناسایی در ابزارها بارگذاری میشوند.
برای کاهش خطا، هر متن باید دستکم در سه سرویس آزمایش شود. ابزارهای رایج این حوزه شامل GPTZero، Originality.ai، Copyleaks، Winston AI، ZeroGPT و سامانههای دانشگاهی مانند Turnitin هستند. این ابزارها روشهای متفاوتی دارند و قرار نیست درصدهای یکسانی نمایش دهند.
نتیجه آزمایش روی متن انسانی چه بود؟
متن انسانی نیز ممکن است از سوی ابزارها به اشتباه محتوای هوش مصنوعی تشخیص داده شود. این اتفاق بهویژه در متنهای رسمی، دانشگاهی، ترجمهشده و نوشتههای نویسندگانی که جملههای منظم و واژگان استاندارد به کار میبرند بیشتر دیده میشود.
در نمونههای انسانی، معمولاً ابزارها در متنهای طولانیتر عملکرد باثباتتری دارند، اما این ثبات به معنی صحت قطعی نیست. متن یک متخصص ممکن است به دلیل لحن دقیق و ساختار منظم، از نظر آماری به متن مدل زبانی شبیه شود. همین موضوع برای نویسندهای که زبان دوم خود را استفاده میکند نیز اهمیت دارد، زیرا برخی پژوهشها و آزمایشها از احتمال برچسبگذاری نادرست چنین متنهایی خبر دادهاند.
نتیجه منفی کاذب نیز ممکن است رخ دهد. اگر نویسنده انسانی از جملههای کوتاه، اصطلاحات تخصصی و ساختارهای تکراری استفاده کند، ابزار ممکن است متن را کاملاً انسانی تشخیص دهد. در نتیجه، امتیاز انسانی بالا نمیتواند ثابت کند که متن حتماً بدون کمک هوش مصنوعی نوشته شده است.
این مسئله نشان میدهد که استفاده از ابزار برای رد یا قبول مقاله یک دانشجو، گزارش کارمند یا متن نویسنده، بدون بررسی شواهد دیگر، تصمیمی پرریسک است. سابقه ویرایش، فایلهای اولیه، منابع مورد استفاده و گفتوگو با نویسنده معمولاً اطلاعات قابل اتکاتری فراهم میکنند.
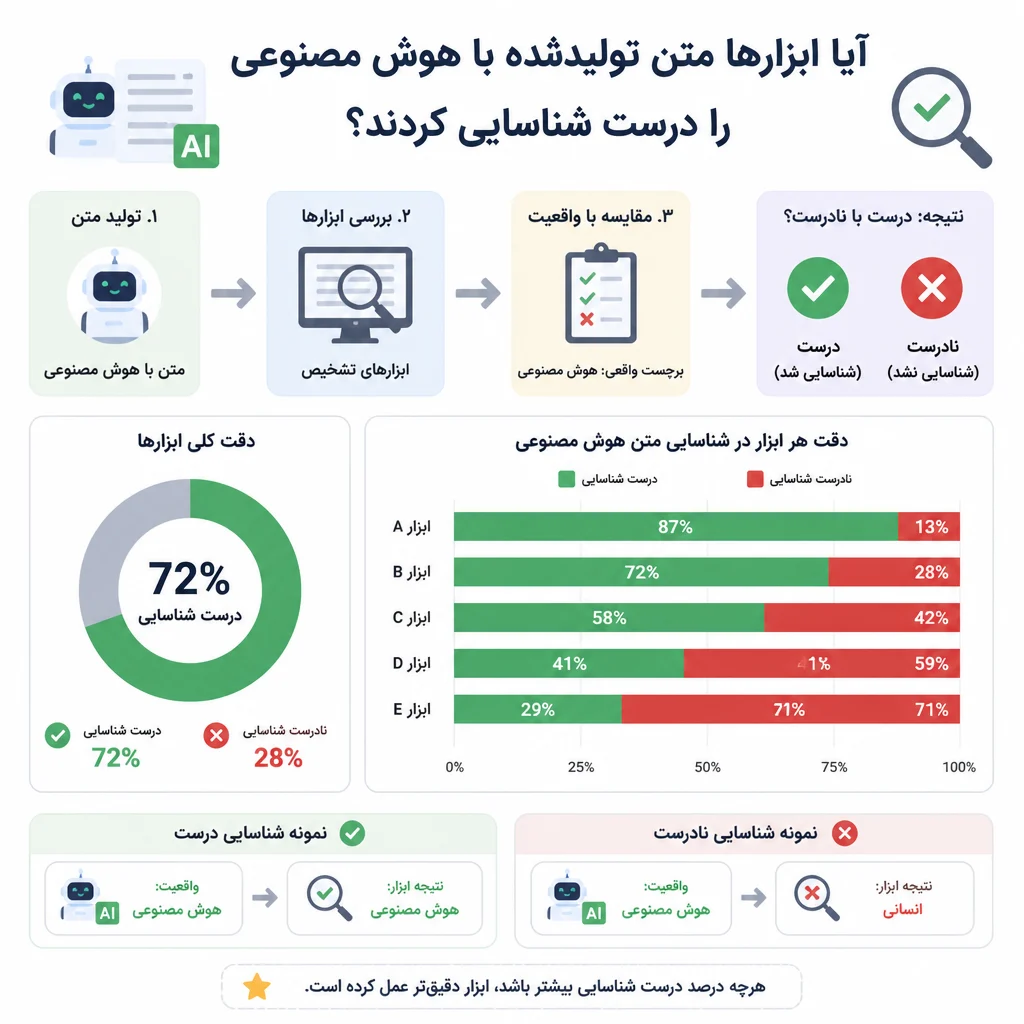
آیا ابزارها متن تولیدشده با هوش مصنوعی را درست شناسایی کردند؟
ابزارها در متن خام و نسبتاً طولانی تولیدشده با مدلهای زبانی معمولاً احتمال هوش مصنوعی را بهتر تشخیص میدهند، اما عملکرد آنها پس از ویرایش، ترجمه یا بازنویسی بهسرعت کاهش مییابد. متن خام اغلب لحن یکنواخت، انتقال منطقی بیش از حد مرتب و عبارتهای عمومی دارد و همین الگوها برای ابزار قابل مشاهده است.
در آزمایشهای عملی، خروجی مدلهای مختلف نیز یکسان نیست. مدلهای قدیمیتر ممکن است نشانههای آماری واضحتری داشته باشند، در حالی که مدلهای جدیدتر با تنوع واژگان، اصلاح ساختار و تولید سبکهای گوناگون، شناسایی را دشوارتر میکنند. همچنین یک دستور دقیق برای نوشتن با لحن شخصی میتواند امتیاز ابزار را تغییر دهد.
طول متن عامل مهمی است. متنهای کمتر از ۲۰۰ یا ۳۰۰ کلمه داده کافی برای تحلیل ندارند و درصد نمایشدادهشده در آنها ناپایدار است. یک پاراگراف کوتاه ممکن است در چند بار آزمایش، نتایج متفاوتی نشان دهد. برای نتیجه معنادارتر، متن باید چند پاراگراف پیوسته و موضوعی مشخص داشته باشد.
ویرایش انسانی هم اثر پیچیدهای دارد. اصلاح چند واژه معمولاً برای تغییر نتیجه کافی نیست، اما بازنویسی عمیق، افزودن تجربه شخصی، حذف جملههای کلی و تغییر ساختار میتواند نشانههای آماری متن را دگرگون کند. با این حال، استفاده از بازنویسی برای پنهان کردن منبع متن، جایگزین نویسندگی مسئولانه و بررسی صحت اطلاعات نیست.
کدام عوامل دقت تشخیص محتوای هوش مصنوعی را کاهش میدهند؟
مهمترین عوامل کاهشدهنده دقت شامل کوتاه بودن متن، زبان کممنبع، ترجمه ماشینی، بازنویسی شدید، موضوع تخصصی و یکنواختی طبیعی سبک نویسنده هستند. این محدودیتها باعث میشوند عدد نهایی ابزار را فقط یک سیگنال اولیه بدانیم.
- زبان: بسیاری از ابزارها ابتدا برای انگلیسی توسعه یافتهاند و در فارسی، عربی یا زبانهای دیگر پوشش یکسانی ندارند.
- طول: نمونه کوتاه الگوی کافی برای تفکیک نویسنده انسانی از مدل زبانی ندارد.
- نوع محتوا: متنهای فنی، حقوقی و دانشگاهی به دلیل ساختار استاندارد ممکن است شبیه خروجی هوش مصنوعی به نظر برسند.
- ترجمه: ترجمه ماشینی میتواند متن انسانی را مصنوعی نشان دهد و متن هوش مصنوعی را نیز از الگوی اصلی خارج کند.
- ویرایش: ویرایش سبک یا بازنویسی کامل، امتیاز ابزار را تغییر میدهد، اما میزان این تغییر قابل پیشبینی نیست.
- نسخه ابزار: مدل تشخیصدهنده، داده آموزشی و معیارهای هر سرویس با سرویس دیگر تفاوت دارد.
در فارسی، مسئله پیچیدهتر است، زیرا بسیاری از ابزارها داده آموزشی و معیارهای ارزیابی گستردهای برای این زبان منتشر نکردهاند. وجود نیمفاصله، تفاوت رسمالخط، تغییر شکل فعلها و تنوع ترجمه واژههای تخصصی نیز میتواند تحلیل را دشوار کند.
چرا دو ابزار برای یک متن نتیجه متفاوت میدهند؟
دو ابزار میتوانند یک متن واحد را با درصدهای کاملاً متفاوت ارزیابی کنند، چون از دادههای آموزشی، مدلهای آماری و آستانههای تصمیمگیری یکسانی استفاده نمیکنند. درصد نمایشدادهشده میان سرویسها معیار استاندارد و قابل مقایسهای نیست.
برای مثال، یک ابزار ممکن است امتیاز ۸۰ درصد را به معنی احتمال زیاد تولید ماشینی بداند، در حالی که ابزار دیگر همان متن را در محدوده نامطمئن قرار دهد. حتی در یک سرویس، تغییر چند جمله یا افزودن عنوان میتواند نتیجه را جابهجا کند.
کاربر باید تفاوت میان امتیاز احتمال و حکم قطعی را بداند. امتیاز ۹۰ درصد به این معنی نیست که احتمال واقعی تولید ماشینی دقیقاً ۹۰ درصد است، زیرا ابزار معمولاً کالیبراسیون عمومی و قابل راستیآزمایی برای همه زبانها، موضوعها و جمعیتها ارائه نمیکند.
در ارزیابی حرفهای، به جای تمرکز بر یک عدد، باید الگوی مشترک چند ابزار بررسی شود. اگر سه ابزار مستقل یک متن طولانی را با اطمینان بالا مشکوک بدانند، این موضوع ارزش بررسی بیشتر دارد، اما هنوز بهتنهایی مدرک قطعی نیست.
آیا ویرایش انسانی، تشخیص را ناممکن میکند؟
ویرایش انسانی میتواند دقت ابزارهای تشخیص را کاهش دهد، اما همیشه متن را از همه آزمونها عبور نمیدهد. میزان اثر به عمق ویرایش، کیفیت متن اولیه و مدل استفادهشده بستگی دارد.
ویرایش سطحی شامل تغییر چند واژه، جابهجایی علائم نگارشی یا افزودن اشتباه عمدی است. این روش هم از نظر کیفیت ضعیف است و هم ممکن است نشانههای دیگری ایجاد کند. ویرایش عمیق شامل بررسی واقعیتها، افزودن تحلیل نویسنده، ترکیب منابع، تغییر منطق ارائه و بازنویسی بر اساس تجربه واقعی است.
هدف درست از ویرایش، بهبود دقت، اصالت و ارزش متن است، نه فریب دادن ابزار. در یک فرایند حرفهای، نویسنده باید بتواند تصمیمهای محتوایی خود را توضیح دهد و برای ادعاهای مهم منبع ارائه کند. این شواهد از هر درصد خودکاری معتبرتر هستند.
برای تیمهایی که از ابزارهایی مانند سرویس تولید محتوای هوشنویسا استفاده میکنند، ثبت brief، منابع، نسخههای ویرایش و تأیید نهایی متخصص میتواند فرایند تولید را شفافتر کند. چنین مستنداتی نشان میدهد که استفاده از ابزار مولد، جایگزین نظارت انسانی و مسئولیت محتوایی نشده است.
آیا استفاده از ابزارهای تشخیص برای سئو ضروری است؟
استفاده از ابزارهای تشخیص برای سئو ضروری نیست، زیرا موتورهای جستوجو بیشتر بر مفید بودن، اصالت، دقت و رضایت کاربر تمرکز میکنند، نه صرفاً بر اینکه متن با انسان یا ماشین تولید شده است.
محتوای تولیدشده با کمک هوش مصنوعی اگر اطلاعات درست، ارزش افزوده، تجربه واقعی و ویرایش تخصصی داشته باشد، میتواند برای کاربر مفید باشد. در مقابل، متن کاملاً انسانی اما سطحی، تکراری یا نادرست نیز کیفیت مناسبی ندارد.
تمرکز اصلی سئو باید بر هدف جستوجو، پوشش کامل موضوع، ساختار قابل خواندن، منابع معتبر، پاسخ مستقیم و تجربه کاربر باشد. یادگیری اصول آموزش سئو و بهینهسازی محتوا به تیمها کمک میکند به جای دنبال کردن یک امتیاز غیرشفاف، کیفیت واقعی صفحه را ارزیابی کنند.
ابزار تشخیص میتواند در کنترل داخلی، آموزش نویسندگان یا شناسایی متنهای مشکوک مفید باشد، اما نباید به معیار اصلی رتبهبندی محتوا تبدیل شود. هیچ گزارش قابل اتکایی نشان نمیدهد که یک درصد خاص از ابزارهای تشخیص مستقیماً عامل رتبه گرفتن یا از دست دادن رتبه باشد.
آیا محتوای هوش مصنوعی باعث جریمه سایت میشود؟
محتوای هوش مصنوعی بهخودیخود دلیل قطعی جریمه سایت نیست، اما محتوای بیکیفیت، فریبنده، تکراری یا تولیدشده برای دستکاری نتایج جستوجو میتواند با افت عملکرد یا اقدامات الگوریتمی روبهرو شود.
برای ناشران، نگرانی واقعی نباید شناسایی شدن توسط یک ابزار ثالث باشد. نگرانی اصلی باید انتشار ادعاهای نادرست، اطلاعات پزشکی یا مالی بدون بررسی، کپیکاری، نبود تجربه تخصصی و تولید انبوه صفحات کمارزش باشد.
مفهوم جریمه محتوای هوش مصنوعی زمانی گمراهکننده میشود که هر افت رتبه به استفاده از مدل زبانی نسبت داده شود. افت ترافیک میتواند دلایلی مانند تغییر الگوریتم، رقابت جدید، مشکل فنی، کاهش تقاضا، لینکهای ضعیف یا قدیمی شدن اطلاعات داشته باشد.
برای کاهش ریسک، هر محتوای تولیدشده با ابزار باید از نظر واقعیت، منبع، نیت جستوجو، تجربه کاربر، ادعاهای حساس و همخوانی با سیاستهای سایت بازبینی شود. انتشار کمتر اما دقیقتر، معمولاً از تولید انبوه متنهای مشابه نتیجه بهتری دارد.
تولید محتوا با هوش مصنوعی چه زمانی قابل قبول است؟
تولید محتوا با هوش مصنوعی زمانی قابل قبول است که ابزار نقش دستیار را داشته باشد و انسان مسئول تحقیق، تصمیمگیری، ویرایش، راستیآزمایی و انتشار نهایی بماند.
کاربردهای مناسب شامل ایدهپردازی، ساخت طرح اولیه، خلاصهسازی منابع، پیشنهاد عنوان، تبدیل داده خام به پیشنویس و یافتن پرسشهای متداول است. در این کاربردها، خروجی اولیه باید نقطه شروع باشد، نه محصول نهایی.
برای محتوای حساس، نظارت تخصصی اهمیت بیشتری دارد. مقاله پزشکی باید توسط فرد آشنا با منابع پزشکی بررسی شود، محتوای حقوقی باید محدودیتهای خود را روشن کند و گزارش مالی باید با دادههای معتبر و بهروز تطبیق داده شود.
اشتباهات تولید محتوا با هوش مصنوعی معمولاً از اعتماد بیش از حد به متن آماده، انتشار اطلاعات ساختگی، استفاده از مثالهای غیرواقعی، تکرار عبارتهای کلی و نادیده گرفتن مخاطب واقعی ناشی میشوند. ایجاد چکلیست کنترل کیفیت میتواند این خطاها را بهطور محسوسی کاهش دهد.
چگونه نتیجه ابزار تشخیص را درست تفسیر کنیم؟
نتیجه ابزار تشخیص باید به عنوان نشانه نیازمند بررسی بیشتر تفسیر شود، نه مدرک قطعی درباره نویسنده متن. هرچه متن کوتاهتر، فارسیتر یا تخصصیتر باشد، احتیاط در تفسیر اهمیت بیشتری دارد.
- طول و زبان متن را بررسی کنید و محدودیت اعلامشده ابزار را بخوانید.
- نتیجه را با دستکم دو ابزار دیگر مقایسه کنید، اما درصدها را مستقیماً با هم جمع یا میانگین نکنید.
- بخشهایی را پیدا کنید که ابزار مشکوک اعلام کرده است و لحن، تکرار و قابل پیشبینی بودن آنها را جداگانه بررسی کنید.
- منابع، سابقه ویرایش، نسخههای قبلی و توضیح نویسنده درباره فرایند تولید را درخواست کنید.
- پیش از هر تصمیم انضباطی، بررسی انسانی و فرصت پاسخگویی را در نظر بگیرید.
در بازاریابی محتوا نیز بهتر است گزارش ابزار در کنار معیارهایی مانند نرخ تعامل، رضایت مخاطب، تبدیل، بازگشت کاربر و صحت اطلاعات تحلیل شود. متن ممکن است از نظر ابزار انسانی به نظر برسد، اما برای مخاطب بیفایده باشد، یا برعکس، بخشی از فرایند تولید ماشینی داشته باشد و با ویرایش حرفهای عملکرد خوبی ایجاد کند.
برای تولید محتوای قابل اعتماد چه فرایندی پیشنهاد میشود؟
فرایند قابل اعتماد با تعریف هدف و مخاطب آغاز میشود و با تحقیق، تولید پیشنویس، بررسی تخصصی، ویرایش انسانی و اندازهگیری عملکرد ادامه پیدا میکند.
- هدف صفحه و پرسش اصلی کاربر را مشخص کنید.
- منابع اولیه و دادههای قابل استناد را پیش از نوشتن جمعآوری کنید.
- اگر از مدل زبانی کمک میگیرید، آن را برای طرح و پیشنویس به کار ببرید.
- ادعاهای عددی، نامها، تاریخها و نقلقولها را جداگانه راستیآزمایی کنید.
- مثالهای واقعی، تجربه تخصصی و دیدگاه متمایز به متن اضافه کنید.
- متن را از نظر خوانایی، ساختار، سئو و انطباق با نیاز مخاطب ویرایش کنید.
- پس از انتشار، بازخورد و دادههای عملکرد را برای بهبود نسخه بعدی بررسی کنید.
چنین فرایندی از وسواس نسبت به نتیجه یک ابزار بهتر است، زیرا کیفیت محتوا را از چند زاویه اندازه میگیرد. ابزارهای تشخیص میتوانند یک لایه کنترل باشند، اما جای تحقیق، تخصص و قضاوت انسانی را نمیگیرند.
جمعبندی آزمایش عملی چیست؟
آزمایش عملی نشان میدهد دقت ابزارهای تشخیص محتوای هوش مصنوعی به زبان، طول، سبک، مدل تولیدکننده و میزان ویرایش وابسته است. متن خام و طولانی معمولاً آسانتر شناسایی میشود، اما متن انسانی رسمی نیز ممکن است به اشتباه علامتگذاری شود و متن بازنویسیشده میتواند از تشخیص عبور کند.
بهترین روش، استفاده ترکیبی از چند ابزار و بررسی شواهد فرایندی است. هیچ درصدی نباید بهتنهایی مبنای رد نویسنده، حذف محتوا، محرومیت آموزشی یا ادعای تخلف قرار گیرد. ارزش واقعی محتوا را دقت، اصالت، فایده و مسئولیتپذیری مشخص میکند.
سوالات متداول (FAQ)
آیا ابزارهای تشخیص محتوای هوش مصنوعی صددرصد دقیقاند؟
خیر. این ابزارها احتمال تولید ماشینی را تخمین میزنند و ممکن است هم متن انسانی را اشتباه علامتگذاری کنند و هم متن تولیدشده را تشخیص ندهند.
بهترین ابزار تشخیص محتوای هوش مصنوعی کدام است؟
ابزار واحدی برای همه زبانها و کاربردها بهترین نیست. انتخاب باید بر اساس زبان، طول متن، نوع محتوا، شفافیت روش ارزیابی و امکان بررسی چندگانه انجام شود.
آیا متن فارسی با دقت خوبی تشخیص داده میشود؟
دقت در فارسی میان ابزارها متفاوت است و معمولاً به اندازه انگلیسی قابل پیشبینی نیست. متن فارسی کوتاه، ترجمهشده یا تخصصی را باید با احتیاط بیشتری ارزیابی کرد.
آیا ویرایش متن، نتیجه ابزار را تغییر میدهد؟
بله. بازنویسی عمیق، افزودن تجربه شخصی و تغییر ساختار میتواند امتیاز ابزار را تغییر دهد، اما هدف ویرایش باید افزایش کیفیت و اصالت باشد، نه فریب سامانه تشخیص.
آیا استفاده از هوش مصنوعی برای سئو ممنوع است؟
خیر، استفاده از هوش مصنوعی بهتنهایی ممنوع نیست. مسئله اصلی، کیفیت، صحت، ارزش افزوده و هدف تولید محتواست، نه صرفاً ابزار مورد استفاده برای تهیه پیشنویس.